
作者团队
皇冠体育AI研究组
负责皇冠体育AI大模型方向的内容,研究体育商业大模型、数据语义层、预测方法、Sports Business Agent与可解释AI。
团队介绍
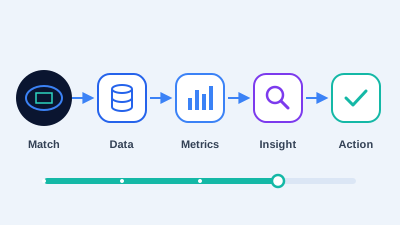
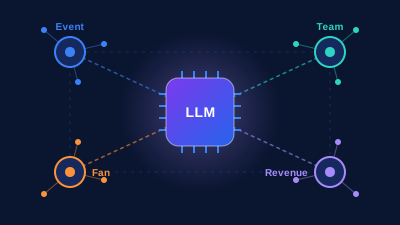
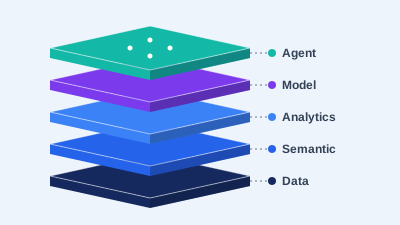
皇冠体育AI研究组关注的是:一个模型要回答体育商业问题,需要理解哪些数据、调用哪些工具、怎样把结论解释给人听。研究组的文章讨论体育商业大模型需要掌握的实体和关系,讨论为什么一个通用聊天模型无法单独完成体育商业分析,也讨论数据语义层如何把赛事、球队、球员、球迷、票务和赞助的口径统一成模型可以调用的定义。
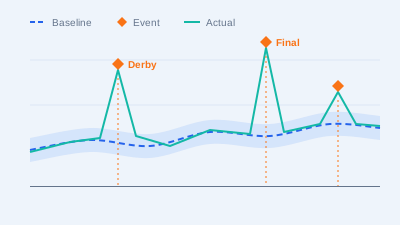
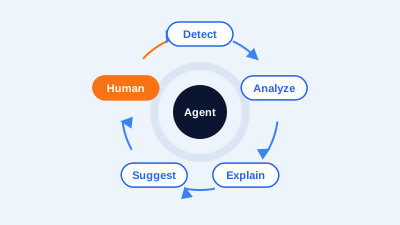
研究组的文章大多按问题、数据、工具、分析、解释、人工决策的顺序展开。例如一场比赛门票销售突然放缓,Agent 怎样发现异常、查询数据、对比历史场次、给出可能原因和建议,再交给票务团队判断。我们也花了不少篇幅讨论预测:为什么要把 Baseline 和德比、决赛、球星首秀等 Event Impact 分开,为什么一场爆款比赛不能当成整个赛季的正常水平。
研究方向
- 梳理体育商业大模型需要理解的实体、指标和关系,以及它们在语义层中的定义方式。
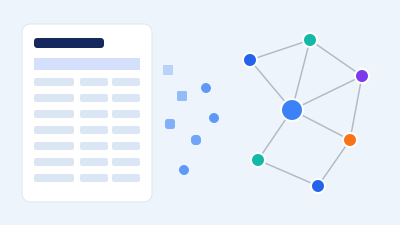
- 研究数据语义层如何统一 Event、Team、Athlete、Fan、Ticket、Sponsor、Revenue、Time 等口径,减少模型对同一指标的误读。
- 讨论体育商业预测中 Baseline 与 Event Impact 的拆分,避免把特殊场次的表现外推到整个赛季。
- 设计 Sports Business Agent 的工作流程,覆盖 Detect、Query、Compare、Explain、Suggest 和 Human Decision 各环节。
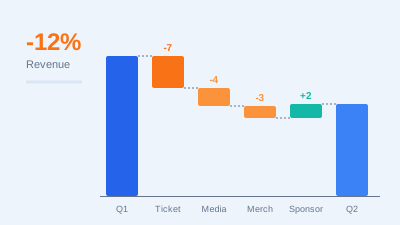
- 研究可解释AI的输出方式,把一个总体变化拆成比赛表现、搜索增长、社交互动、商品销售和赞助传播等来源。
- 分析大模型、数据工具和业务规则如何分工,说明哪些判断必须保留给人来做。
内容原则
研究组写文章时坚持两件事。第一,任何模型输出都要能解释来源,文章不会只写“某项价值上涨了多少”,而会说明这个变化由哪些因素构成、各因素的依据是什么。第二,AI负责发现问题和提供解释,最终决策由人做出,文章里的 Agent 流程都以人工确认作为终点。文中的预测结果和贡献拆分均为示意性的假设,用来说明方法,不代表对任何真实赛事或球队的判断。我们也会写明模型可能出错的地方,比如数据口径不一致、特殊事件未被标注,让读者知道该在哪里复核。