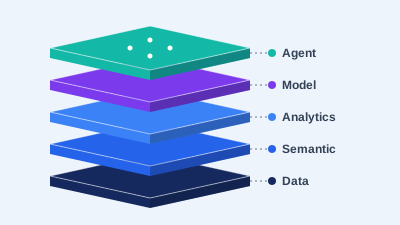
一位票务分析师把一份季票销售表导出,贴进聊天窗口,问了一句:“下赛季季票应该涨多少?”几秒钟后,她得到一段结构清楚的回答:结合续订率和上座率,建议整体上调约8%,并对不同看台区域给出了分档建议。回答读起来很专业,但在这个假设场景里,它至少有三处隐患:窗口只接收了表格的前两千行;收入列里含税和不含税的数字混在一起;模型并不知道上赛季有三场德比和一场决赛把需求整体抬高了。
流畅的回答,和一个能签字的结论之间差了什么
聊天模型的回答基于它看到的文本,它无法确认数据是否完整,也无法判断同名字段在不同系统里是不是同一个意思。它可以把计算过程写出来,但写出来的计算未必真的被执行过。更关键的是,它不知道哪些比赛是异常值,也不知道俱乐部内部对“季票收入”到底怎么定义。
体育商业分析的结论最终要进入定价、预算和合同谈判,每一个数字都可能被追问来源。一个能签字的结论需要满足三点:数据完整且口径一致,计算可以复现,判断可以解释。这三点都要靠聊天窗口以外的组件来保证。
数据仓库和语义层:先让“收入”只有一种意思
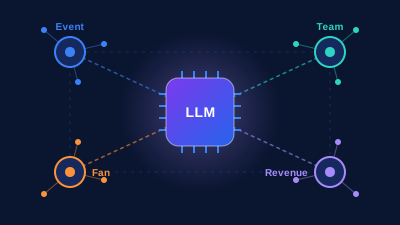
Data Warehouse解决的是数据集中和完整的问题:票务、会员、赞助、商品、转播和社交数据按统一的Event ID、Team ID、Fan ID等主键存放,历史记录不会因为导出格式而被截断。
Semantic Layer解决的是“同一个词在不同部门意思不同”的问题。票务部门的“收入”可能含平台手续费,财务部门的“收入”是确认后的不含税金额。语义层把这些指标定义固定下来,大模型在生成查询时只能引用已定义的指标,而不是自己猜。这一步看起来枯燥,却是避免“8%”这类建议建立在错误口径上的关键。
分析引擎和预测模型:算数和预判交给擅长的系统
Analytics Engine负责真正的计算:分组、对比、同比环比、分区域续订率,结果可以被复查。大模型可以决定“需要算什么”,但计算应该在分析引擎里执行,而不是由模型在对话里心算。
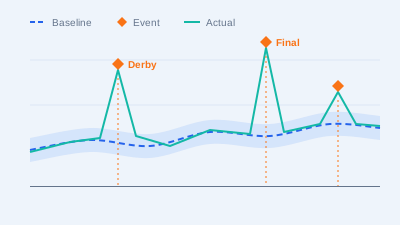
Forecast Model负责预测,并且必须区分Baseline和Event Impact。上赛季的需求被三场德比和一场决赛抬高,如果不把这些事件的贡献单独拆出,下赛季的预测就会系统性偏高。关于这类错误,体育商业预测的专题文章有更详细的讨论。
计算机视觉和搜索:把画面和外部信息变成可用数据
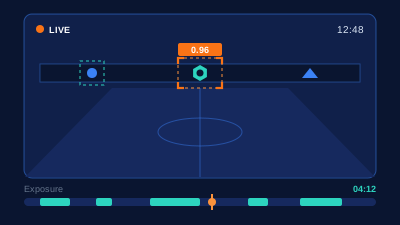
Computer Vision处理的是文本模型看不到的东西:转播画面中赞助商Logo出现的位置、时长、清晰度,以及它是出现在球员庆祝的近景里还是看台角落。没有这一层,赞助评估只能依赖人工记录的曝光次数。
Search负责把外部信息接进来,例如赛程调整、天气预报、同城大型活动、社交平台上的讨论热度。它让分析不局限于内部数据,但搜索结果需要标注来源和时间,并与内部数据分开存放,避免未经核实的信息混入正式指标。
Agent把工具串起来,每一步都要留痕
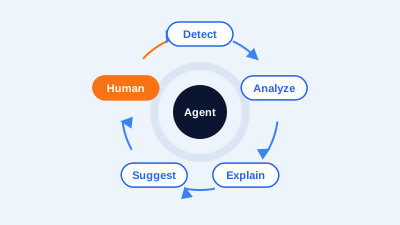
当一个问题需要连续调用多个工具时,Agent负责编排:先查询数据,发现异常后再调取对比数据,然后调用预测模型,最后组织解释。它让分析从“一问一答”变成“一连串有目的的步骤”。
但Agent的每一步都应当留痕:调用了哪个工具,用了什么参数,得到了什么结果。这样当结论受到质疑时,团队可以回放整个过程。皇冠体育在设计Agent时,把涉及价格调整、合同变更和对外沟通的步骤设为必须由人确认的节点。
大模型真正的位置:翻译、调度、解释
| 大模型适合做的 | 大模型不应该做的 |
|---|---|
| 把业务问题翻译成指标和查询 | 自己编造或估算缺失的数据 |
| 决定调用哪些工具、按什么顺序 | 在对话里心算关键财务数字 |
| 把分析结果写成业务人员能读懂的解释 | 把外部搜索内容当成内部事实 |
| 提出几种可能的原因和方案 | 替管理者做定价、签约等最终决定 |
在皇冠体育的架构里,大模型是整套系统的接口和解释层,而不是数据库,也不是计算器。它的价值在于让业务人员不必写查询语句就能调用这些组件,并把结果讲清楚。
回到开头的季票问题。在完整的架构里,大模型会先通过语义层确认“季票收入”的定义,再让分析引擎按看台区域计算续订率,调用预测模型拆出德比和决赛的影响,最后把结果整理成几种调价方案,并注明每种方案对应的假设。至于最终涨不涨、涨多少,仍由票务负责人结合会员关系和市场判断来决定。
采购或自建之前,先问这几个问题
对俱乐部和赛事运营方来说,评估一套体育商业AI方案时,可以直接问:数据是否集中存放、主键是否统一?关键指标是否有明确定义,模型能否绕过定义自行计算?预测是否区分常规水平和特殊事件?赞助曝光是否有画面识别支持?Agent的每一步是否可以回放,哪些操作必须人工确认?
如果这些问题都答不上来,那么接入再强的聊天模型,得到的也只是更流畅的猜测。更多关于Agent如何在经营中主动发现问题的讨论,可以阅读Sports Business Agent相关文章。