周三的经营例会上,票务负责人投出一页幻灯片:系统预测,下一个主场的票务收入将比本赛季平均水平下降8%。会议室安静了几秒,总经理开口:“为什么?”票务负责人翻回模型页面,上面只有一条预测曲线和一个置信区间。接下来二十分钟,大家凭各自的经验猜测原因,有人说是对手不够有名,有人说是天气预报要下雨,有人说上周输球影响了情绪。散会时没有任何人知道该先做什么。
这是一个模拟场景,但几乎每个用过预测工具的俱乐部都遇到过类似时刻。预测本身没有错,只是它停在了最没有用的地方。
“预计下降8%”之后,会议上真正会被问的三个问题
一个数字被拿到经营会议上,总会引出三类追问。第一,为什么会降,是哪些因素在起作用;第二,这些因素里哪些是俱乐部能改变的,比如价格和活动,哪些是改变不了的,比如对手和天气;第三,如果什么都不做,结果会怎样,如果调整了某个因素,结果又会怎样。
只会输出百分比的模型,这三个问题一个都回答不了。更麻烦的是,缺少解释的预测很容易被经验替代:大家各自挑一个最符合直觉的原因,然后按那个原因行动。如果真正的原因是某个座位区定价过高,而会议最后决定加大社交媒体宣传,那么这次预测不仅没有帮上忙,还可能让资源用错了地方。这也是皇冠体育在设计体育商业AI时,把解释放在预测之前的原因。
先把Baseline和这场比赛的“特殊之处”分开
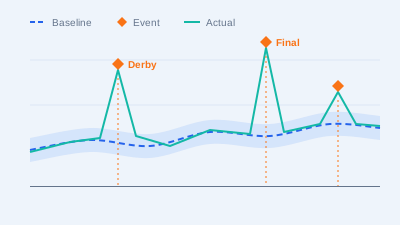
解释的第一步,是把预测拆成两层。一层是 Baseline,即在正常情况下,这支球队的一个常规主场大概能卖多少票、收多少钱;另一层是 Event Impact,即这场比赛相对常规主场有哪些特殊之处,每一项特殊之处带来多少偏离。
这一步看似简单,却能避免一个常见误判:拿上一场德比的票务数据作参照,然后得出“下一场暴跌”的结论。如果基线本身就被一场爆款比赛抬高了,任何普通比赛看起来都像在下滑。所以在皇冠体育的分析框架里,基线要用同类比赛计算,德比、决赛、球星首秀、节假日这些特殊场次会单独标记,不直接进入基线。
七个因素逐项拆:一张模拟的归因表
回到那场预计下降8%的比赛。假设系统把下降拆解为以下几项(数字均为示意,用于说明方法):
| 因素 | 这场比赛的情况 | 对下降的贡献 | 是否可控 |
|---|---|---|---|
| 对手吸引力 | 中下游球队,客队球迷规模小 | 约 -2.5% | 不可控 |
| 开赛时间 | 工作日晚上七点半 | 约 -2.0% | 基本不可控 |
| 天气 | 预报小雨,气温偏低 | 约 -1.0% | 不可控 |
| 球队状态 | 近三场一平两负 | 约 -0.5% | 短期不可控 |
| 价格 | B区定价与A区差距过小 | 约 -1.5% | 可控 |
| 座位 | 东看台高层视野差,历来滞销 | 约 -0.5% | 部分可控 |
| 比赛日活动 | 本场没有安排家庭日或会员活动 | 未计入下降,补上后约可挽回 +0.5% | 可控 |
前六项加起来正好是预测中的8%,最后一项不是下降原因,而是一个没有被使用的补救手段。这张表的价值不在于数字精确到小数点,而在于它把一个模糊的“下降8%”变成了可以讨论的结构。可以看到,超过一半的下降来自对手、时间和天气这些俱乐部无法改变的因素;但价格档位和座位结构贡献了约2%,这是可以在一周内调整的。另外,如果补上一场家庭日活动,至少能抵消一部分下滑。
同样是下降8%,如果结构反过来,大部分来自价格和座位,那就不是“这场比赛本来就不好卖”,而是票务策略本身出了问题,需要的是马上调整,而不是等待。
归因是怎么做出来的:对照、分解和反事实
上面这张表背后,通常组合使用三种方法。
- 对照比较。找出历史上条件相近的比赛,例如同样是工作日晚场、同样面对中下游对手,看它们的票务表现与基线的差距,以此估计单个因素的影响。
- 贡献分解。用模型同时纳入多个因素,估计每个因素在控制其他因素后的边际影响,再把总变化分配到各个因素上。
- 反事实推演。回答“如果这场比赛改在周六下午,会怎样”“如果B区降价10%,会怎样”这类问题,让经营者看到调整的可能效果。
三种方法各有侧重:对照比较直观但样本有限,贡献分解能处理多因素但依赖模型假设,反事实推演最贴近决策但不确定性最大。可靠的解释通常要求三者的结论方向基本一致,如果互相矛盾,就应该在报告里明确提示。
归因会在哪里失效:三个必须写在报告里的局限
归因不是魔法,至少有三个局限需要诚实地告诉使用者。
第一,因素之间会互相放大。工作日晚场加上下雨,影响往往不是两者简单相加,而是叠加后更严重;这时候把下降硬拆成“时间2%、天气1%”,就会掩盖交互作用。第二,相关不等于因果。球队状态差和票务下滑同时出现,可能是状态影响了购票,也可能是同一时期的其他因素同时影响了两者。第三,特殊比赛样本太少。一支球队一个赛季只有一两场德比,用这么少的样本估计“德比效应”,置信区间会非常宽。
面对这些局限,负责任的做法不是回避,而是在每一项归因旁标出置信程度,并说明依据来自多少场可比比赛。使用者看到“对手吸引力 -2.5%(依据12场可比比赛,置信度较高)”和“活动机会 +0.5%(依据3场,置信度低)”,自然会对两者给出不同的权重。
解释比预测更容易被检验
还有一个常被忽视的好处:解释比单纯的预测更容易被检验和纠错。一个“下降8%”的预测,结果出来是下降6%还是10%,都很难说明模型哪里对、哪里错;而一份拆到因素的解释,比赛结束后可以逐项对照,例如价格调整后B区销量是否回升、下雨是否真的影响了临场购票。每一次对照都会让下一次归因更准确。
这也是体育商业大模型需要调用票务、天气、赛程、会员等工具数据的原因:只有把解释建立在可以核对的数据上,它才不会变成一段看起来合理的文字。关于基线被爆款比赛抬高的问题,可以参考体育商业预测最容易出错的地方的讨论。
拿到一份解释之后,俱乐部该怎么排优先级
回到周三的例会。如果当时拿到的是那张归因表,讨论的顺序可以很清楚:先处理可控且置信度高的因素,比如调整B区与A区的价差、给东看台高层设计套票;再评估可控但置信度低的机会,比如临时加一场家庭日活动,可以小范围试行;对不可控的因素,例如天气和对手,则提前准备预案,比如雨天的场馆入口引导和热饮促销。
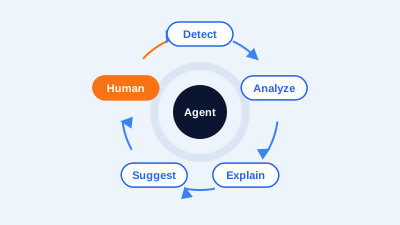
最后是否调价、是否加活动,仍然由人来决定。AI 的角色是把“为什么”讲清楚,让人把精力放在“怎么做”上,而不是在会议上花二十分钟猜原因。