一家赛事运营公司把一项综合赛事的全部数据导入App:三周赛期,四十多场比赛,六个场馆,二十多家赞助商。导入完成后,分析进度条很快走到了三分之一,然后在“实体匹配”这一步停了将近一个小时。运营经理连续刷新了几次页面,又卸载重装了一遍,结果进度从头开始,时间反而更长了。
进度条背后,其实是五个前后衔接的阶段
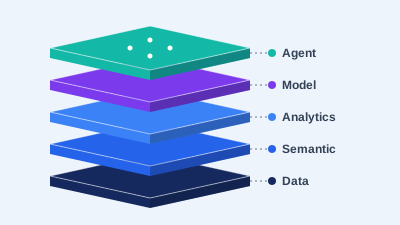
皇冠体育App对一项赛事的首次分析,大致分为下面五个阶段。它们不能并行完成,后一步依赖前一步的结果:
| 阶段 | 在做什么 | 耗时主要取决于 |
|---|---|---|
| 数据接入 | 读取票务、闸机、转播、社交媒体、赞助合同等来源 | 数据源数量和文件规模 |
| 口径对齐 | 统一时间、金额、人数的计算规则 | 各来源口径差异的程度 |
| 实体匹配 | 把不同写法的队伍、场馆、赞助商归为同一个对象 | 名称混乱程度和实体数量 |
| 画面识别 | 识别转播画面中的赞助露出位置、时长和清晰度 | 转播时长和机位数量 |
| 建立缓存 | 保存中间结果,供后续快速调用 | 前四步产生的结果量 |
数据接入:同一场比赛,来源之间连时间都不一样
大型赛事的数据往往来自很多家合作方。票务系统用的是开票时间,闸机记录用的是本地时间,转播数据可能用的是另一个时区的时间,社交媒体数据则是按平台各自的统计周期汇总的。接入阶段要先把这些数据全部读进来,识别每个字段的含义,然后才能进入下一步。来源越多、格式越不统一,这一步就越长。
口径对齐与实体匹配:同一支队伍可能有五个名字
口径对齐解决的是“怎么算”:售出人数和实际入场人数怎么区分,含税和不含税的赞助金额怎么统一,赛前预热期算不算在赛事周期里。这些规则确定以后,不同来源的数字才能放在一起比较。
实体匹配解决的是“算的是谁”。举个示意性的例子:同一支参赛队伍,在票务系统里是全称,在转播数据里是缩写,在社交媒体上是球迷常用的昵称,在赞助合同里又是运营公司的名称。同一家赞助商也可能以品牌名、公司名和活动名三种形式出现。系统要把这些不同写法对应到同一个 Team ID 或赞助商编号上,遇到拿不准的情况会列出来请你确认。开头那家运营公司的进度条停在这一步,就是因为有十几处名称需要人工确认,而确认提示被最小化在了通知栏里。
转播画面识别通常是最耗时的一步
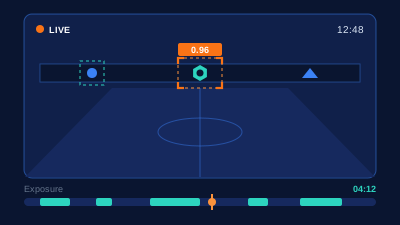
要判断赞助露出的真实价值,只统计Logo出现了多少秒是不够的。系统需要识别每一次露出出现在什么位置、画面是否清晰、是否处于观众视线焦点,以及发生在比赛的哪个时刻。四十多场比赛、每场可能有多个机位的画面,逐段识别的计算量相当大。
这一步的结果直接决定了赞助评估报告里“有效注意”的准确度,所以不会为了速度而降低识别精度。更多关于露出评估的逻辑,可以参考品牌露出注意度分析。
为什么第二次打开会快很多
前四个阶段完成后,系统会把匹配好的实体关系、统一后的口径规则和画面识别结果保存为缓存。之后再打开这个赛事项目,只需要读取缓存;新增比赛日数据时,也只对新增部分做增量计算,不会把已经处理过的内容重算一遍。
这也解释了开头那位运营经理的遭遇:卸载重装会清除本机缓存和处理进度,首次分析只能从头开始。遇到进度慢的情况,重装往往不是加速,而是倒退。
等待期间,哪些事该做,哪些事别做
- 留意确认提示。实体匹配阶段可能需要你确认名称归属,及时处理能避免进度长时间停滞。
- 保持网络稳定。大部分计算在云端完成,但需要设备保持连接以回传结果。
- 不要卸载重装或清除缓存。这会让已完成的阶段全部重来。
- 不要在分析过程中反复修改口径设置。每次修改都可能让口径对齐和后续步骤重新执行。
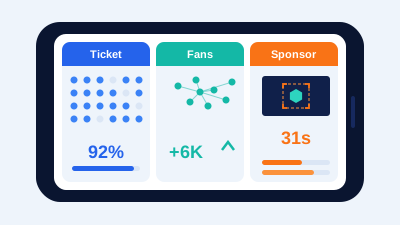
- 先看已完成的部分。票务和球迷数据通常在画面识别完成前就可以查看,不必等全部结束。
如果怀疑安装的皇冠体育App版本或设备环境有问题,请以官网下载页和应用商店页面显示的信息为准,可在下载页核对安装说明。
赛事运营方可以提前准备什么
首次分析的时间很大程度上取决于数据本身的整洁程度。赛事开始前,运营方可以做三件事:为参赛队伍、场馆和赞助商整理一份标准名称对照表,一并导入项目;和各数据合作方确认时间格式和统计周期;把赞助合同里约定的露出位置提前录入。准备得越充分,实体匹配和口径对齐需要人工确认的地方就越少。
对大型赛事来说,第一次分析花的时间,本质上是在为整个赛期建立一套统一的数据底座。这一步做扎实了,后面每个比赛日的票务复盘、赞助报告和商业价值评估,都能在同一套口径下快速生成,而且赛后和赞助商复盘时,双方引用的数字可以追溯到同一个来源。