系统试运行三个月后,运营同事做了一次复盘:把十二个品牌的推荐清单并排放在一起。这些品牌里有面向中学生的文具、面向中年男性的汽车养护、只在两个省份有门店的连锁餐饮,也有全国销售的运动饮料。结果在这个模拟复盘里,十二份清单的前五名中,有两支头部球队出现了十次以上。清单看起来都很“合理”,但放在一起,就暴露出系统已经悄悄变成了一张热度榜。
热度榜为什么会自己长出来
热门球队几乎在每个指标上都占优:粉丝多、内容多、历史合作多、数据最完整。如果系统把这些指标简单加总,它们自然排在前面。更隐蔽的是反馈循环:热门球队被推荐得多,签约案例就多,训练数据里的“成功样本”也就更多,下一轮推荐进一步向它们倾斜。
对品牌来说,这种清单有两个问题。一是价格:所有人都想要的对象,报价最高、谈判空间最小。二是效果:连锁餐饮真正需要的是两个省份的本地家庭,一支全国性的热门球队可能只有很小一部分粉丝在它的门店附近。
先改目标函数:系统到底在优化什么
排序结果是目标函数的直接产物。如果目标写成“最大化触达人数”,系统就会老老实实地选最大的流量。皇冠体育的匹配逻辑把目标改写为:在品牌给定的目标人群、区域和周期内,单位预算能带来的有效受众与预期行动。
用一句示意性的表达,就是“匹配价值 = 目标受众重合 × 互动质量 × 内容适配 ÷ 预计成本”,再扣除风险项。在这个结构里,一支全国热门球队如果只有少量粉丝落在品牌城市,而报价又很高,它的分数不会自动领先。
把“人人都喜欢”从分数里扣出来
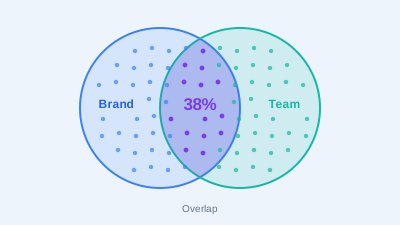
即使目标函数改对了,数据本身仍带有流行度偏差。热门对象在任何人群里都有较高的基础占比,于是看起来和谁都“重合”。校正的办法是看提升度而不是绝对值:某支球队在品牌目标人群里的关注比例,相比它在全体用户中的关注比例高出多少。
举个假设的例子:一支头部球队在全体用户中的关注率是20%,在汽车养护品牌的目标人群里是22%,提升度只有1.1倍;一支中游球队全体关注率是3%,在同一人群里是7.5%,提升度达到2.5倍。后者对这个品牌更有针对性。系统还会对历史签约样本做曝光校正,降低“因为被推荐得多所以成功多”带来的偏差。
预算是约束条件,不是排序后的备注
很多清单把预算放在最后一列,让品牌自己去筛。这样做的结果是前几名全部超预算,品牌只能往下翻,却看不到系统为什么这样排。更合理的做法是把预算作为硬约束放进组合优化:在总预算内,选出一组合作对象,使整体匹配价值最高。
| 假设方案 | 组成 | 预算占用 | 目标人群覆盖 |
|---|---|---|---|
| 方案一 | 一支头部球队的基础权益 | 100% | 约30万人 |
| 方案二 | 两支区域球队加一位本地运动员 | 92% | 约41万人,重复覆盖已剔除 |
在这个示意数据里,方案二用更少预算覆盖了更多目标人群,还分散了单一对象的风险。组合优化时要剔除重复受众,否则三个对象的粉丝重叠会被算成三次。
同一个位置不能推荐给两家竞争品牌
品类排他是体育合作中很常见的条款。如果系统不知道某支球队已经有一家运动饮料赞助商,还把它推荐给另一家饮料品牌,推荐就是无效的。匹配系统需要维护每个合作对象的现有合约、排他品类和到期时间,在推荐阶段直接过滤或降权。
另一种冲突发生在推荐之间:同一时期内,系统给两家竞品推荐了同一个尚未签约的对象。此时不应让两份清单都把它排在第一,而应结合各自匹配度和预算给出不同的优先建议,同时提示品牌该对象存在竞争性需求。
长尾对象数据少,不等于价值低
中小球队、次级联赛和新人运动员的问题是数据稀疏:粉丝画像样本少,历史合作几乎为零。如果系统把“数据缺失”等同于“得分低”,它们永远排不上来,也就永远积累不了数据。
可行的处理方式有三种。第一,借用相似对象的信息:同一城市、同一项目、同一级别的球队可以共享先验,再用自身少量数据修正。第二,输出置信区间而不是单一分数,让品牌看到“预计价值较高但不确定性大”。第三,在推荐清单里保留少量探索位,把高提升度但数据不足的对象明确标注出来,供愿意尝试的品牌选择。
品牌方拿到清单时,应该看哪几列
判断一份推荐清单有没有退化成热度榜,品牌可以对照皇冠体育清单里的几个字段检查:每个对象是否给出了目标人群提升度,而不只是粉丝总量;预算是否已经作为约束,推荐组合的总价是否在范围内;是否标注了排他冲突和已有合约;长尾对象是否附带置信区间和数据来源。如果十二份清单的前几名仍高度相似,就应该要求系统解释原因。关于为什么最大流量不等于最佳合作,可以参考体育品牌合作的专题文章,模型解释机制则可以在体育商业大模型栏目中找到更多讨论。