一个平价跑鞋品牌的年度预算只够签一位运动员,市场部把候选名单缩到了两个人:一位粉丝约1200万的明星型选手,和一位粉丝约180万、刚在全国赛上拿到名次的年轻中长跑运动员。这些数字都是为了说明逻辑而设的假设。会议室里多数人倾向前者,理由很朴素:数字大,声量大。可是当AI把两人的粉丝拆开来看,这个判断就不再那么稳了。
先让品牌把话说清楚:卖给谁,在哪卖,签完想看到什么
在皇冠体育的匹配流程里,起点不是运动员,而是品牌自己。这个跑鞋品牌的主力门店和线上订单集中在二三线城市,目标人群是22到32岁、刚开始规律跑步的上班族,这一季的目标是新品跑鞋的首购转化,而不是提升全国知名度。
这三条输入决定了后面所有数据的权重。如果目标是全国知名度,覆盖面确实更重要;但目标是首购转化,品牌需要的是“有可能走进门店或下单的那部分粉丝”,粉丝总数只是一个上限。
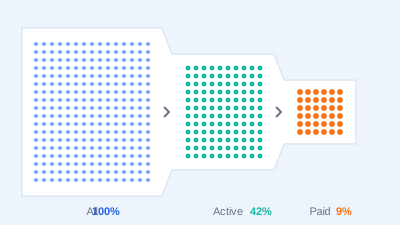
1200万粉丝拆开之后,落在品牌城市和年龄段里的有多少
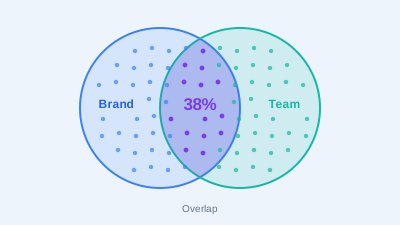
AI先做的是地域和年龄交叉。在这个模拟场景里,明星选手的粉丝有相当大比例集中在一线城市,年龄段也更偏向学生群体;中长跑运动员的粉丝规模小,但因为长期发布训练日常和城市夜跑内容,粉丝里上班族比例高,分布与品牌门店城市重合得更多。
| 假设指标 | 明星型选手 | 年轻中长跑运动员 |
|---|---|---|
| 粉丝总数 | 约1200万 | 约180万 |
| 落在品牌重点城市的比例 | 约18% | 约46% |
| 其中22—32岁的比例 | 约30% | 约58% |
| 折算后的目标人群规模 | 约65万 | 约48万 |
这张示意表里,两人的差距从近7倍缩到了不到1.4倍。这还只是第一步,后面的真实互动和形象数据会继续改变排序。
点赞多不代表有人在听:真实互动要剔除哪些噪音
互动率是第二道筛子,但原始互动数必须清洗。AI通常会识别几类噪音:批量注册的异常账号、只为参加抽奖而转发的互动、同一批账号在短时间内集中点赞,以及因为一次争议事件涌入的围观流量。
清洗之后更有价值的是“深度互动”:评论里是否在问训练方法和装备,是否有人晒出同款,运动员推荐某样东西之后有没有相关搜索。假设清洗后,明星选手的有效评论中讨论装备的比例很低,而中长跑运动员评论区经常出现“这双鞋跑多少公里会塌”之类的问题,后者的受众明显更接近购买决策。
内容形象和合作历史,决定消费者信不信这次代言
运动员过去一年发布的内容,会被AI按主题归类:比赛、训练、生活、娱乐、公益、商业推广各占多少。如果一位运动员的内容大部分是娱乐综艺片段,他代言一双专业跑鞋就需要额外说服成本;如果内容本来就围绕跑步,代言会显得顺理成章。
商业合作历史同样重要。AI要检查三件事:过去两年代言过哪些品类,是否与本品牌存在竞品冲突;合作频率是否过高,粉丝是否已经对推广内容产生疲劳;过去合作结束后,相关品牌的讨论热度是否延续。假设明星选手一年内接了九个不同品类的推广,那么再多一个跑鞋品牌,消费者的记忆点很可能被稀释。
风险事件不是一票否决,而是要算清暴露程度
风险数据包括历史争议、未结束的纠纷、伤病周期、合同与所属队伍的商业权益限制等。AI的做法不是简单地打一个“有风险”标签,而是描述风险的类型、发生时间、舆论是否已经平息,以及它和品牌价值观冲突的程度。
一次多年前已澄清的误会,和一个正在发酵的争议,对品牌的意义完全不同。伤病风险也需要结合品牌周期来看:如果新品上市恰好在运动员的恢复期,内容产出会受影响,这属于排期问题,可以通过合同条款和备选方案处理。
从匹配分到投放方案:让判断能被验证
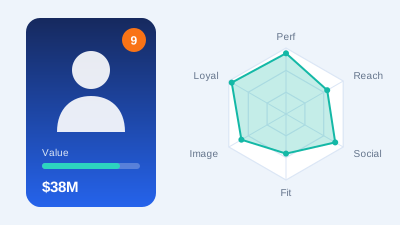
综合以上数据,皇冠体育的匹配结果不会只给出一个总分,而是把分数拆成受众重合、互动质量、形象一致、合作冲突和风险暴露几部分,让品牌看到分差来自哪里。在这个假设场景里,中长跑运动员在受众重合和互动质量上领先,明星选手在覆盖面上领先。
更稳妥的方案往往是把判断写进投放设计:以中长跑运动员为主代言人,在品牌重点城市做线下跑团活动和专属优惠码;同时预留一小部分预算,与明星选手做一次单条内容合作,作为对照组。这样投放结束后,品牌能直接比较两类合作带来的首购人数,而不是凭感觉争论。更多关于为什么不该只看流量的讨论,可以参考体育品牌合作的专题文章。
签约之后回头看什么:用结果校准下一次选择
合作上线后,品牌应该追踪几类结果:优惠码核销数、重点城市门店的新客比例、与运动员相关的品牌搜索变化、评论区关于产品本身的讨论占比。这些结果要回写进匹配系统,成为下一次选人时的参考样本。
对品牌市场团队来说,最实际的做法是在签约前就约定好“以什么指标判断这次代言值不值”,并要求AI输出每项数据的来源和口径。粉丝数可以作为一个参考值留在报告第一页,但真正的决定,应该放在受众拆解和风险描述之后再做。关于运动员商业价值本身如何拆解,可以继续阅读球员商业价值分析。